
질문은 한 번인데 왜 더 비쌀까 — 오래 생각하는 제미나이 3.8 플래시
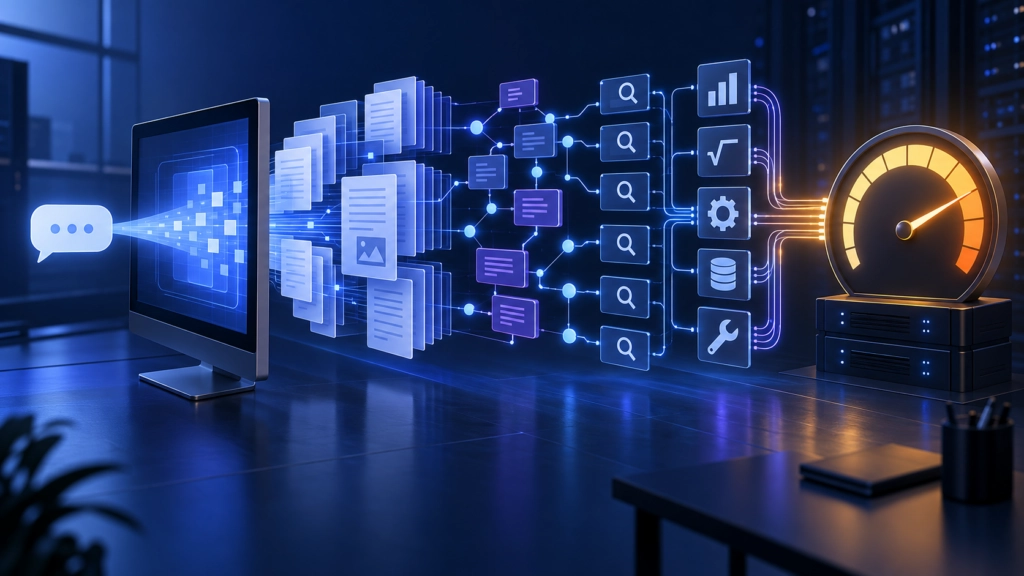
“세종시의 내일 날씨를 한 줄로 알려줘”도 질문 한 번이다. 200쪽 보고서를 올리고 “앞뒤가 맞지 않는 대목을 근거 자료와 대조해 수정안을 만들어줘”라고 시키는 것도 질문 한 번이다.
전송 버튼은 똑같이 한 번이지만 AI가 처리하는 일의 양은 전혀 다르다. AI 이용료와 사용 한도는 질문 횟수로 정해지지 않는다. 얼마나 읽고, 얼마나 오래 생각하고, 얼마나 길게 답하며, 검색이나 계산을 몇 번 했는지가 사용량을 결정한다.
구글이 2026년 9월 2일 공개한 ‘제미나이 3.8 플래시’가 관심을 끈 까닭도 여기에 있다. 현재 표준 API의 토큰 단가는 이전 모델과 같지만, 어려운 문제를 풀 때 더 많은 일을 하도록 만들어졌다. 답이 좋아진 만큼 사용량이 늘 수 있다는 뜻이다.
토큰은 AI가 글을 세는 단위다
사람은 문장을 단어와 뜻으로 읽지만, AI는 ‘토큰’이라는 작은 조각으로 나누어 읽는다. 토큰 하나가 늘 한 글자나 한 단어인 것은 아니다. 짧고 자주 쓰는 단어는 통째로 한 토큰이 되고, 길거나 낯선 단어는 여러 토큰으로 나뉜다. 한국어와 영어를 나누는 방식도 같지 않다(구글의 토큰 설명).
쉽게 말하면 토큰은 AI가 글을 담아 나르는 작은 상자다. 문장이 길수록 상자가 많이 필요하지만, 글자 수만으로 상자 수를 짐작할 수는 없다.
사용량에는 먼저 사용자가 보낸 질문이 들어간다. 첨부한 문서·사진·음성도 포함되고, 대화를 길게 이어가면 앞선 내용까지 짐이 된다. 여기에 AI가 속으로 문제를 푸는 데 쓴 생각, 검색·프로그램 실행 같은 도구 사용, 화면에 내놓은 답변이 더해진다. 결국 읽은 양, 생각한 양, 도구를 쓴 양, 답변한 양—이 네 가지가 사용량을 정한다.
같은 질문도 대화가 길어지면 무거워진다
빈 대화창에서 “이 문장을 다듬어줘”라고 하는 것과, 수십 차례 오간 뒤 같은 부탁을 하는 것은 같지 않다. 뒤의 경우 AI는 ‘이 문장’이 무엇인지 알려고 앞선 대화를 함께 살핀다. 주고받은 원고가 길수록 새 질문에 딸려가는 내용도 늘어난다.
파일도 마찬가지다. 두 쪽 요약과 책 한 권 분석은 버튼을 한 번 눌렀다는 점만 같다. 답변 길이도 중요하다. “세 줄로”와 “표를 포함해 5천 자로”는 내놓을 양부터 다르고, 검색·계산·코드 시험을 시키면 도구를 부를 때마다 일이 붙는다.
그래서 유료 AI의 한도는 “질문을 몇 번 할 수 있다”로 잘라 말하기 어렵다. 짧은 질문은 여러 번 되지만, 긴 문서와 깊은 추론을 요구하면 몇 번만으로도 사용량이 빠르게 준다.
플래시가 답하기 전에 일을 더 벌인다
기존 플래시 계열은 빠르고 값싼 모델이었다. 간단한 질문과 요약에 알맞았다. 3.8 플래시는 한 걸음 더 나아가, 어려운 문제를 받으면 곧바로 답하지 않고 여러 단계로 나누어 생각한다. 도구를 불러 결과를 확인하고, 부족하면 다시 시도한다.
프로그램을 만들어 달라면 코드를 한 번 쓰고 끝내지 않고 실제로 실행해 오류를 고친 뒤 다시 시험한다. 자료조사에서는 검색어를 바꿔가며 여러 자료를 비교한다. 최종 답은 짧아도 뒤에서는 여러 차례 일이 벌어진다. 식당에서 완성된 요리만 보이지만 손질과 조리 과정까지 값에 들어가는 것과 같다. 이 과정에서 오래 생각한 몫도 공식 가격표에 따라 출력 토큰으로 함께 계산된다.
더 버지가 인용한 독립 평가기관의 시험도 같은 대목을 짚는다. 토큰 단가는 이전 3.7 플래시와 같지만, 3.8 플래시는 ‘더 열심히’ 추론 단계와 도구 호출을 늘리도록 설계돼 같은 일에도 토큰을 더 쓸 수 있다는 것이다. 단가는 그대로여도 계산서는 커질 수 있다.
최신 모델을 모든 일에 쓸 필요는 없다
더 많이 생각하는 것이 늘 이익은 아니다. 복잡한 개발이나 계약서 분석에서는 여러 번 확인하는 편이 낫지만, 맞춤법 하나를 고치는 데까지 긴 추론을 거치면 시간과 사용량을 낭비한다. 구글도 효율이 중요하면 사고 강도를 낮추거나 이전 모델인 3.7 플래시를 쓰라고 안내한다.
토큰값이 당장 청구되지 않더라도 이 문제는 중요하다. 구독형에서는 정해진 기간에 사용할 수 있 양이 줄고, 개발자 서비스에서는 늘어난 비용이 이용료에 반영되기 때문이다.
이제 AI를 비교할 때 “질문 한 번에 얼마인가”로는 정확한 답을 얻기 어렵다. 하나를 끝내려고 얼마를 읽고, 몇 단계 생각하고, 도구를 몇 번 썼는지까지 보아야 한다. 제미나이 3.8 플래시는 더 똑똑해진 동시에 더 많은 일을 벌이는 모델이다. 가격표는 그대로여도 계산서가 달라질 수 있는 이유가 여기에 있다.
Q&A
Q. 질문을 한 번만 해도 사용량이 많이 줄 수 있나요?
그렇다. 질문 횟수보다 AI가 읽은 문서의 양, 생각한 단계, 검색·계산 같은 도구 사용, 답변 길이가 사용량을 결정한다. 긴 문서 분석이나 복잡한 프로그램 작업은 질문 한 번으로도 많은 토큰을 쓸 수 있다.
Q. 제미나이 3.8 플래시는 항상 이전 모델보다 비싼가요?
반드시 그런 것은 아니다. 현재 표준 API의 토큰 단가는 3.7 플래시와 같지만, 복잡한 작업에서는 추론과 도구 사용이 늘어 전체 토큰 소비가 커질 수 있다. 간단한 작업은 사고 강도를 낮추거나 효율적인 모델을 선택하는 편이 낫다.
참고자료
korecult

댓글 0
첫 댓글을 남겨보세요.