
AI 경쟁의 새 단위는 전력이다 — 엔비디아가 ‘와트당 에이전트 성능’을 꺼낸 이유
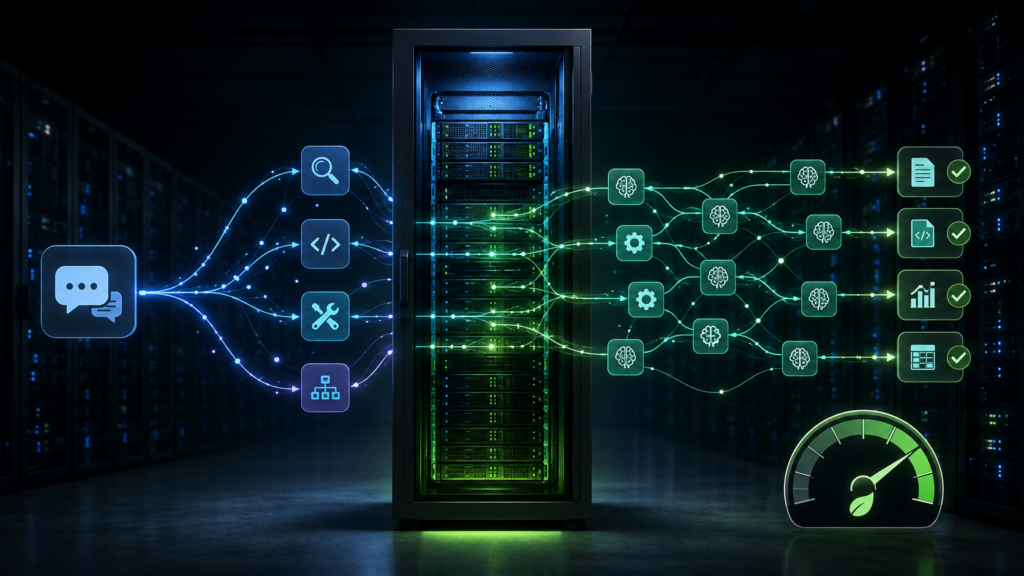
AI 경쟁의 평가 기준이 다시 달라지고 있다. 처음에는 모델 규모와 정답률이 중요했고, 이후에는 응답 속도와 토큰 비용이 부각됐다. 이제 AI가 여러 도구와 하위 에이전트를 동원해 장시간 일하기 시작하면서 전력 효율이 산업 경쟁력의 핵심으로 떠올랐다.
엔비디아가 2026년 8월 24일 공개한 자료에 따르면 차세대 Vera Rubin NVL72 시스템은 이전 세대 GB300 NVL72보다 메가와트당 처리량이 최대 30배 높고, 100만 토큰당 비용은 최대 35분의 1로 낮게 측정됐다. 신제품의 단순 속도 향상이 아니라 AI 에이전트를 상시 운영할 수 있는 경제성을 내세운 발표다.
에이전트는 왜 많은 토큰을 쓰는가
일반 챗봇은 질문을 받고 한 차례 답한다. 에이전트는 목표를 해석한 뒤 자료 검색, 데이터베이스 조회, 코드 실행, 결과 검토를 연속해 수행한다. 복잡한 과제에서는 하위 에이전트에게 일부 업무를 나누고 그 결과를 다시 종합한다.
앞 단계의 대화와 작업 결과가 다음 단계 입력에 계속 포함되므로 문맥은 빠르게 길어진다. 엔비디아가 인용한 OpenRouter 통계에서는 에이전트형 작업이 단순 대화보다 약 15배 많은 토큰을 소비했다. 모든 작업에 적용되는 고정 비율은 아니지만, 에이전트 운영비가 일반 채팅과 다른 구조임을 보여준다.
따라서 한 번의 답변 속도만 측정해서는 실제 성능을 판단하기 어렵다. 검색과 도구 호출, 하위 에이전트 가동까지 포함한 전체 업무량을 전력 및 비용과 함께 계산해야 한다.
‘30배’ 수치에는 조건이 있다
엔비디아는 실제 에이전트 코딩 작업을 기록한 SemiAnalysis의 AgentX 워크로드를 사용했다. 문맥 증가와 도구 호출, 하위 에이전트 생성 과정도 시험에 포함했다. 최대 30배라는 결과는 이 환경에서 DeepSeek V4 Pro 모델을 실행했을 때 나타났다.
그러므로 “모든 AI 작업이 30배 빨라졌다”고 해석해서는 안 된다. 특정 모델과 에이전트 작업에서 메가와트당 처리량이 최대 30배 높게 측정됐다는 의미다. 결과는 아직 SemiAnalysis의 최종 검토 전이며, 도구 호출을 담당할 Vera CPU 성능도 반영되지 않았다. 제조사가 공개한 초기 측정치라는 한계를 함께 봐야 한다.
칩보다 전체 구조가 중요하다
효율 향상의 중심에는 GPU 하나가 아니라 시스템 공동설계가 있다. 긴 문맥을 읽는 단계와 답변 생성 단계를 분리해 각각 알맞은 GPU에 배정하고, 이미 계산한 문맥은 캐시에 보존한다. 후속 요청은 관련 문맥을 보유한 GPU로 보내 중복 계산을 줄인다.
GPU 간 고속 연결과 분산형 KV 캐시, 저정밀 연산, CUDA 커널, TensorRT LLM, Dynamo도 함께 작동한다. 칩·메모리·네트워크·소프트웨어가 하나의 생산체계로 결합해야 실제 전력 효율이 높아진다. AI 경쟁의 중심이 거대한 모델이나 강력한 칩 하나에서 효율적인 전체 시스템으로 이동했다는 의미다.
전력 효율은 서비스 가격으로 이어진다
데이터센터가 사용할 수 있는 전력에는 한계가 있다. 동일한 1메가와트로 더 많은 에이전트 업무를 처리하면 고객 수용량이 늘고 토큰 가격도 낮아질 수 있다. 기업이 AI 에이전트를 시험용이 아니라 상시 업무에 배치할 가능성도 커진다.
그러나 기계 한 대의 효율 향상이 전체 전력 소비 감소를 보장하지는 않는다. 운영비가 낮아지면 AI 이용량이 더 빠르게 증가할 수 있다. 장비 효율과 데이터센터 총소비량을 구분해야 하는 이유다.
이번 발표에서 주목할 부분은 30배라는 숫자보다 평가 단위의 변화다. 에이전트 시대의 경쟁력은 지능만으로 결정되지 않는다. 같은 전력과 비용으로 얼마나 많은 판단과 행동을 지속하느냐가 다음 승부처다.
Q&A
Q. CUDA 커널이란 무엇인가?
GPU에 계산 방법을 직접 지시하는 작은 실행 프로그램이다. 여러 계산과 데이터 이동을 하나로 묶으면 GPU가 기다리는 시간을 줄일 수 있다.
Q. TensorRT LLM은 무엇인가?
대규모 언어모델이 엔비디아 GPU에서 더 빠르고 효율적으로 작동하도록 추론 과정을 최적화하는 소프트웨어다. 엔비디아 설명 보기
Q. Dynamo는 무엇인가?
많은 GPU와 서버에 AI 요청을 알맞게 배분하고 문맥 캐시를 관리하는 추론 운영체계다. 엔비디아 설명 보기
korecult

댓글 0
첫 댓글을 남겨보세요.