
학습하지 않는 AI 반도체? OpenAI의 할라페뇨
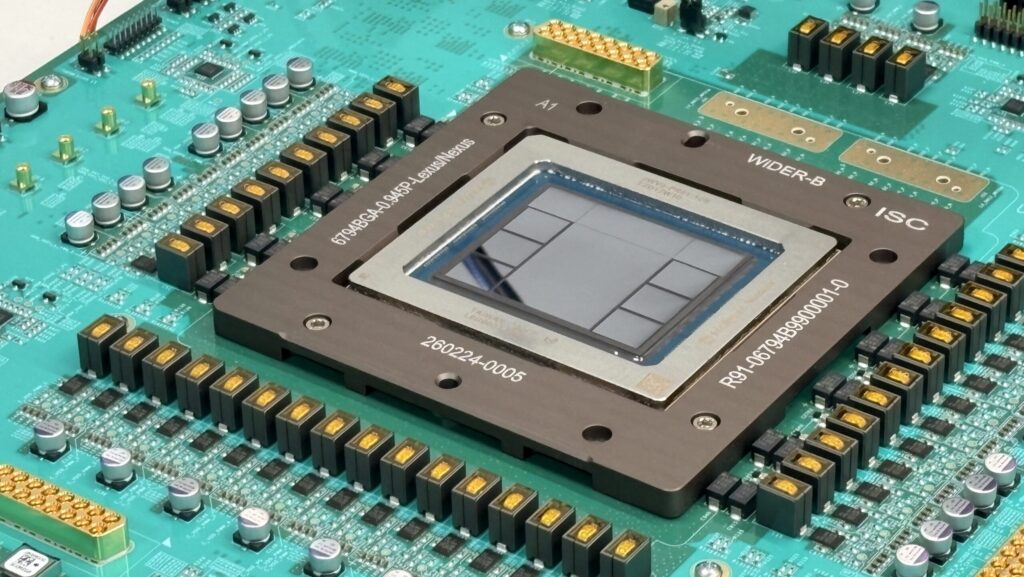
사진=OpenAI
매일 아침 이메일로 몇 가지 기술 소식을 받아본다. 모두 이해하지는 못한다. 이날은 기술 정보지 ‘더 코드(The Code)’가 전한 OpenAI의 첫 인공지능 반도체 소식이 눈에 걸렸다.
OpenAI가 Broadcom과 개발한 추론용 반도체 ‘할라페뇨(Jalapeño)’의 성능시험 결과를 공개했으며, 속도와 효율에서 엔비디아의 GB200·GB300을 앞섰다는 내용이었다. ChatGPT의 응답이 빨라질 수 있으며, 추론 전용이므로 학습에는 사용하지 않는다고 했다.
소프트웨어 기업이 어떻게 반도체를 설계했으며, 학습하지 않는 반도체가 어떻게 추론한다는 말일까.
OpenAI가 반도체를 설계한 이유
OpenAI가 반도체의 모든 부분을 혼자 만든 것은 아니다. OpenAI는 ChatGPT를 운영하며 파악한 계산·메모리·통신의 병목을 바탕으로 필요한 구조를 설계했다. Broadcom은 이를 실제 회로와 네트워크 시스템으로 구현했고, Celestica는 기판과 서버랙 통합에 참여했다.
OpenAI가 용도와 구조를 정하고 반도체 전문기업이 제품으로 구현한 공동개발 방식이다.
학습과 추론은 다른 과정이다
학습은 방대한 자료를 입력하고 오류를 바로잡으며 모델의 내부 수치를 만드는 과정이다. 추론은 학습을 마친 모델의 내부 수치를 이용하여 질문에 답하는 과정이다.
책을 읽고 지식을 익히는 단계가 학습이라면, 익힌 지식으로 문제를 푸는 단계가 추론이다. 시험문제를 풀 때마다 처음부터 다시 공부하지는 않는다.
할라페뇨도 스스로 학습하지 않는다. 다른 장비에서 이미 학습한 모델을 가져와 답변에 필요한 계산만 빠르게 처리한다. 따라서 ‘학습하지 않는 AI 반도체’가 아니라 ‘학습된 AI의 실행을 전담하는 반도체’다.
Blackwell을 앞섰다는 의미
기사의 “엔비디아 Blackwell을 앞섰다”는 표현을 문자 그대로 이해할 수는 없다.
GPT-OSS 120B에서는 할라페뇨를 GB200과, DeepSeek R1 및 Kimi K2.5에서는 GB300과 비교했다. 모든 인공지능 작업에서 앞선 것이 아니라, 특정 언어모델의 추론시험에서 전력효율과 응답속도가 높았다는 뜻이다.
OpenAI는 할라페뇨의 전력당 작업량이 비교 대상보다 약 1.5~1.9배 높고, 전체 응답 지연시간은 약 1.7~3.6배 낮았다고 발표했다. 다만 OpenAI가 공개한 자체 측정 결과이므로 다양한 기관의 재시험과 실제 운영결과를 더 지켜봐야 한다.
확인된 결과와 기대는 구분해야 한다
추론속도가 빨라지면 ChatGPT와 인공지능 에이전트의 응답도 민첩해질 수 있다. 같은 전력으로 더 많은 질문을 처리하면 접속 안정성도 높일 수 있다.
OpenAI는 2026년 말까지 자사 전산기반에 할라페뇨를 배치하기 시작할 계획이다. 엔비디아 반도체도 학습과 추론에 계속 사용할 예정이다.
이번 발표의 핵심은 OpenAI가 엔비디아를 완전히 넘어섰다는 데 있지 않다. AI 기업이 모델뿐 아니라 반도체·메모리·네트워크까지 함께 설계하기 시작했다는 데 있다. 인공지능 경쟁의 무대가 모델에서 데이터센터 전체로 넓어지고 있다.
참고자료
OpenAI, ‘Jalapeño’s first results show industry-leading speed and efficiency in AI inference’, 2026년 8월 25일
OpenAI, ‘OpenAI and Broadcom unveil LLM-optimized inference chip’, 2026년 6월 24일
korecult

댓글 0
첫 댓글을 남겨보세요.