
AI가 긴 작업에서 길을 잃는 까닭 — 더 큰 모델보다 ‘확인된 작업기억’이 필요했다
AI에게 한 가지 질문을 던지면 제법 정확히 답한다. 그러나 파일을 찾고, 여러 도구를 호출하고, 결과를 점검하며 수십 단계를 이어가게 하면 상황이 달라진다. 끝낸 일을 다시 하거나, 아직 하지 않은 일을 완료했다고 판단한다. 처음 지시는 기억하면서도 지금 무엇을 해야 하는지는 놓친다.
흔히 이를 모델의 지능 부족으로 설명한다. 최근 프린스턴대·스탠퍼드대·옥스퍼드대·싱가포르국립대 연구진이 공개한 ‘리커리스’ 연구는 다른 진단을 내놓았다. 긴 작업의 실패는 지식이 부족해서만이 아니라, 진행상태와 경험을 한데 섞어 관리하기 때문에 커진다는 것이다.
대화기록이 길수록 현재 상태는 흐려진다
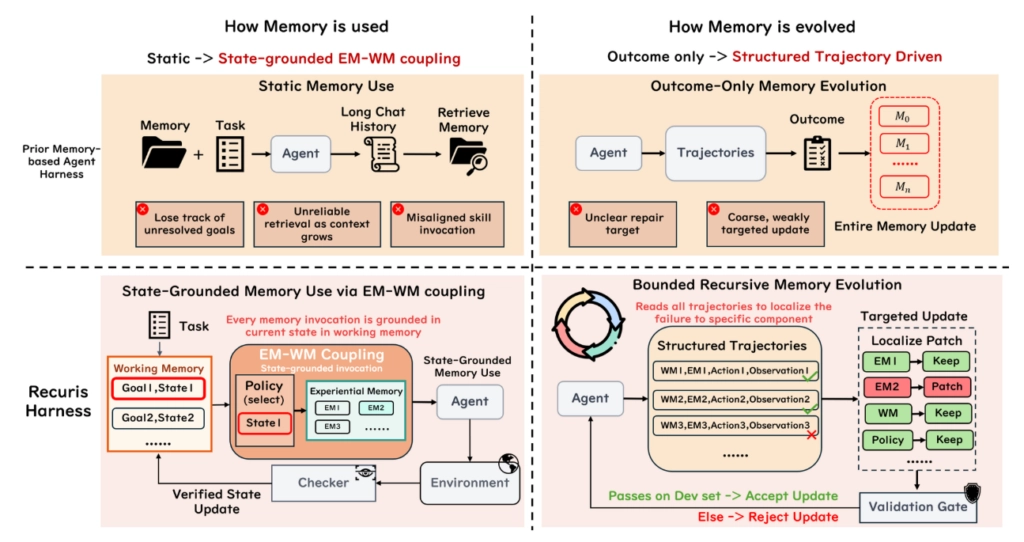
일반적인 AI 에이전트는 처음 받은 지시와 지금까지의 대화기록을 읽고 다음 행동을 결정한다. 짧은 작업에서는 충분하다. 그러나 실행이 길어지면 기록 안에 완료된 단계, 실패한 시도, 오래된 정보, 아직 남은 목표가 뒤섞인다.
문제는 기억의 양보다 구분이다. “무엇을 알고 있는가”와 “지금 어디까지 끝냈는가”가 분리되지 않으면, 관련 없는 절차를 불러오거나 이미 완료한 일을 반복한다. 도구가 실패했는데도 성공한 것으로 기록하면 이후 판단 전체가 틀어진다.
리커리스는 이를 두 종류의 기억으로 나눴다. ‘경험기억’에는 반복해서 쓸 수 있는 방법과 기술을 저장한다. ‘작업기억’에는 현재 목표, 완료 여부, 아직 해결되지 않은 항목을 짧고 구조화된 상태로 기록한다. 다음 기술은 긴 대화 전체가 아니라 이 작업상태를 기준으로 선택한다.
AI의 말이 아니라 도구의 결과로 완료를 판정한다
더 중요한 장치는 검증이다. 시스템은 실행 과정에 ‘완료’라고 표시되었다는 이유만으로 작업이 끝났다고 판단하지 않는다. 파일이 실제로 생성되거나 주문 변경이 도구의 응답으로 확인되는 등 외부 결과가 뒷받침될 때만 해당 단계를 완료로 기록하고 작업기억을 갱신한다.
구조는 간단하다. 현재 상태를 확인하고, 필요한 기술을 선택하고, 도구를 실행하고, 실제 결과로 상태를 갱신한다. 이 순환을 반복하면 대화가 길어져도 ‘현재 해야 할 일’이 오래된 기록에 묻히지 않는다.
실패를 고치는 방식도 제한적이다. 메타 에이전트가 실행기록을 살펴 경험기억, 작업상태 형식, 기술 선택 규칙, 검증기 가운데 어디에서 문제가 생겼는지 찾는다. 전체 지침을 다시 쓰지 않고 잘못된 부분만 수정하며, 별도 검증 과제에서 기존 능력이 떨어지지 않을 때만 수정안을 받아들인다. 기본 언어모델의 가중치는 바꾸지 않는다.
최상위 모델도 기억 구조에 따라 성패가 갈렸다
연구진은 네 종류의 장기과제와 열 개 모델에서 이 구조를 시험했다. 완료된 37개 ‘모델–평가과제’ 조합 가운데 35개에서 성공률이 높아졌다고 보고했다. 소매 업무 평가에서 GPT-5.6 Sol은 58.3%에서 76.1%로, Claude Opus 5는 72.4%에서 87.9%로 올랐다. 상호작용이 가장 긴 과제군에서는 개선 폭이 32.2%포인트에 이르렀다.
흥미로운 대목은 모델을 새로 학습시키지 않고도 결과가 달라졌다는 점이다. 같은 지능이라도 어떤 기억을 언제 불러오고, 완료 여부를 무엇으로 확인하느냐에 따라 실행 신뢰도가 크게 달라졌다.
그러나 이 결과도 연구진이 설계한 평가환경에서 얻은 사전논문 수치다. 실제 기업 업무는 권한 충돌, 예외 상황, 잘못된 외부 데이터가 더 많다. 장기간 운영에서도 개선된 기억이 누적 오류를 만들지 않는지 독립 검증이 필요하다. ‘스스로 진화하는 AI가 완성됐다’고 확대할 단계는 아니다.
자동화의 핵심은 더 긴 지시문이 아니다
이 연구는 실무 자동화에 분명한 교훈을 준다. 긴 지시문에 모든 규칙을 넣는다고 안정성이 보장되지 않는다. 작업표를 따로 두고, 각 단계의 완료조건을 정하며, 실제 산출물이 확인된 뒤에만 다음 단계로 넘어가야 한다.
문서 수집과 OCR, 번역, 파일 합치기처럼 단계가 많은 작업도 같다. 어느 페이지까지 확보했는지, 어떤 파일이 검증됐는지, 실패한 단계가 무엇인지 별도 상태표로 관리하면 대화기록에만 의존할 때보다 재작업을 줄일 수 있다. AI 자동화의 경쟁력은 모델이 얼마나 유창한가보다, 실행상태를 얼마나 냉정하게 기록하고 확인하는가에서 갈릴 가능성이 크다.
Q&A
Q. 작업기억과 경험기억은 어떻게 다른가요?
작업기억은 현재 과제가 어디까지 진행됐고 무엇이 남았는지를 기록합니다. 경험기억은 여러 과제에서 반복해서 사용할 수 있는 절차와 기술을 저장합니다.
Q. AI가 스스로 완료했다고 말하면 작업이 끝난 것인가요?
아닙니다. 리커리스는 파일 생성이나 주문 변경처럼 외부 도구의 결과가 확인될 때만 해당 단계를 완료로 기록합니다. AI의 설명보다 실제 실행 결과를 우선합니다.
Q. 리커리스는 AI 모델 자체를 다시 학습시키나요?
아닙니다. 기본 언어모델은 고정하고, 모델 바깥에 있는 작업기억·경험기억·기술 선택·검증 구조만 제한적으로 수정합니다.
참고자료
Zhaochen Yu 외, ‘Recursive Experiential–Working Memory Evolution for Long-Horizon Agent Harnesses’, arXiv, 2026년 8월 25일
Gen-Verse, Recuris 공개 코드와 실험자료
korecult

댓글 0
첫 댓글을 남겨보세요.